
Day 4 在研究 chunking 時,我遇到一個有點尷尬的問題。
原本的需求其實寫得很簡單:
把英文自動切成適合練習的 chunks。
乍看之下,好像已經很清楚了。
但真的往下拆之後,我才發現,「適合練習」至少就可能有兩種意思。
一種是比較小、方便拆解和模仿的 learning chunk;另一種則是比較接近自然說話節奏的 thought group。
也就是說,同一句需求,可以做出兩種完全不同、卻都不能說是錯的結果。
這也讓我開始重新看前面列出來的其他功能。
如果連「自動切段」這四個字底下都藏了這麼多產品決策,那我真的可以直接拿著一張 feature list 開始寫程式嗎?
我以前做 side project 時其實寫過 spec,工作上也曾經自己開過 API spec,所以這件事對我並不完全陌生。
不過過去更多時候,我接到的是別人已經整理好的需求,再往下做模型或實作。
這次比較不一樣。
我要自己從「我想做一個什麼產品」一路走到「這東西到底要怎麼運作」。
一開始,我手上的東西比較像這樣:
每一項看起來都很合理。
但它們其實只回答了:
這個產品要有哪些功能?
還沒有回答:
使用者實際會怎麼使用?每一步到底會發生什麼?
這兩件事差很多。
以前做模型 API 時,我遇過一個很實際的問題。
有一次,一個 request 需要回傳不只一組預測結果,而且每組結果又和其他條件有關。
這時候光說:
API 要回傳多組 prediction。
其實完全不夠。
真正開始設計時,很快就會冒出問題:
如果這些沒有先講清楚,開發 API 的人可能覺得自己的設計很合理,串接的人卻會一頭霧水。
而 Product Spec 做的事情其實有點像把這個概念放大到整個產品。
「要回傳什麼」是需求;「對方最後實際會拿到什麼」才是 contract。
同樣地:
Support Shadowing.
是一個需求。
但:
使用者先聽參考語音,再跟讀,可以錄下自己的版本、回放,不熟就再練一次。
才開始接近產品真的會怎麼運作。
Day 3 已經做了一次 scope 收斂。
完整產品未來可能包含:
但第一版先不全部做。
這一版先假設:
使用者已經有一段自己想練的英文。
接下來只處理:
貼入內容 → 分段 → 聽 → 跟讀 → 錄音 → 回放 → 完整演練
而像 AI 改寫、ASR、發音評分、AI feedback、個人化,都先放在後面。
Spec 不只是寫「我要做什麼」,也要正式寫下「這一版不做什麼」。
否則一個看起來很合理的小功能,很容易又默默長回 scope 裡。
原本我有:
Chunking、TTS、Recording、Playback。
這些都只是 capabilities。
真的從使用者角度走一次,才會變成:
貼入英文
→ 自動切段
→ 確認分段
→ 逐段練習
→ 完整演練
這時候我才比較能想像:
使用者進來第一眼看到什麼?
按下 Start Practice 之後發生什麼?
Chunk 切完之後,是直接播放,還是先讓他確認?
一小段一小段練完之後,又要去哪裡?
這些問題不是在增加新功能。
它們只是在把原本散落的功能,串成一件使用者真的能完成的事情。
功能清單告訴我產品有什麼;使用流程才告訴我使用者怎麼完成一件事。
再往下一層,還有一個問題。
假設 spec 上只寫:
支援 Shadowing。
還是太模糊。
因為「支援 Shadowing」可以有很多做法。
我最後把一次基本練習拆成:
聽參考語音 → 跟讀 → 錄音 → 回放 → 覺得不熟就再一次
這時候才比較知道介面至少需要什麼:
Day 4 的 chunking 其實也是一樣。
自動切段
只是 feature。
什麼叫切得好?
才是在定義 behavior。
整理完之後,大概是長的像下面這樣的流程:
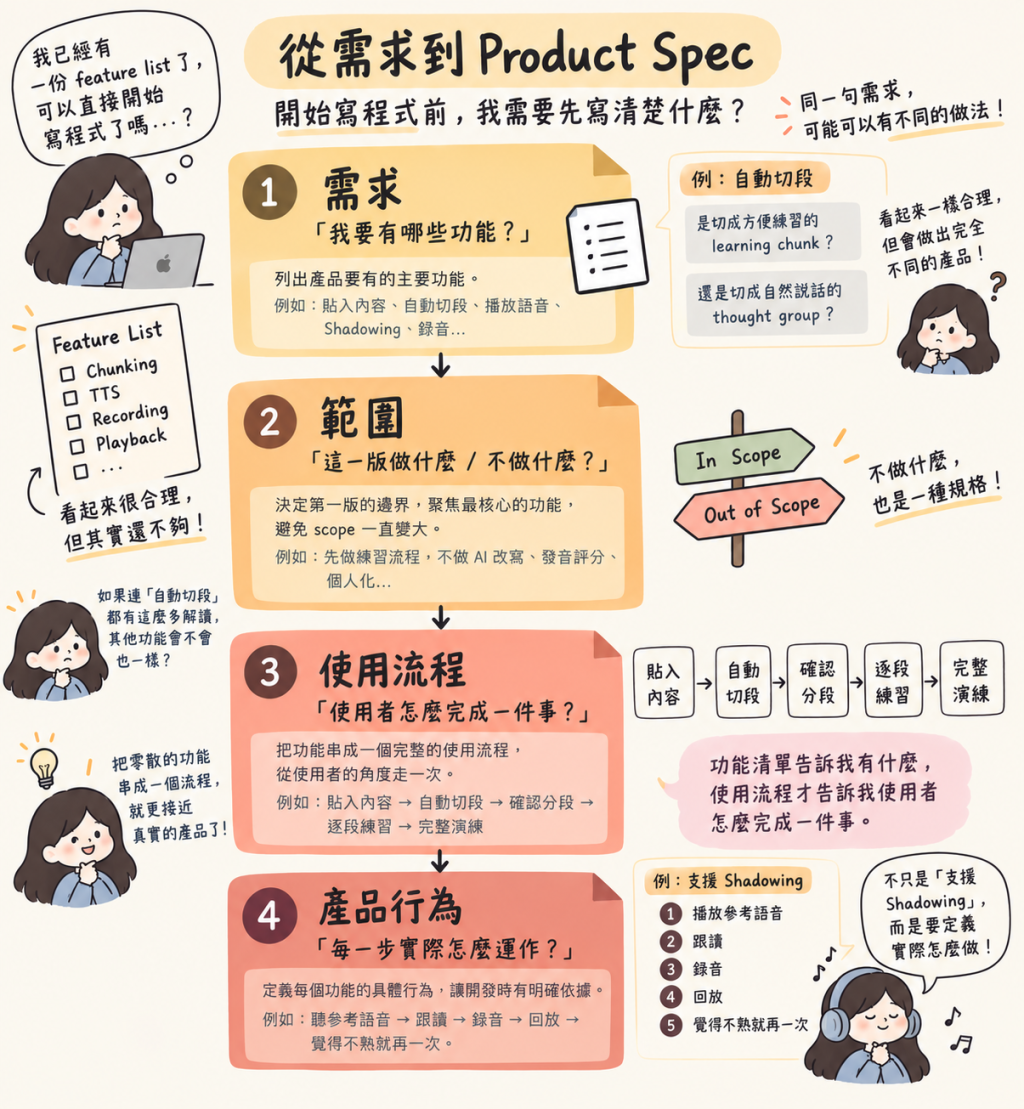
我以前看到 Product Spec,我對它的基本認知是「把需求寫詳細一點」。
但這次自己真的從零往下拆之後,我覺得它比較像是在「消除不同人腦中的版本差異」。
如果同一句 requirement 可以合理地做成兩個完全不同的產品,那它可能還沒有寫清楚。
不過,寫到這裡又會出現下一個問題。
如果每一個細節都可以繼續往下拆,那 Product Spec 到底要寫到多細?
是不是所有情況都要在開始寫程式前想完?
這就是我下一步要處理的問題。


 iThome鐵人賽
 看影片追技術